计量经济学语言
从“听不懂”到“会翻译”
2026-10-14
先别急着学公式
“哟斯呗嗟嘎?哈粤郭。”
你听到了什么?请先独立猜测 10 秒,再与同桌交换答案。
你猜对了吗?如果没有,是知识不足,还是语言规则尚未共享?
同一句话,三个世界
发音
“哟斯呗嗟嘎?
哈粤郭。”
只接收到声音。
我的误译
“你是北京来的?
唱个歌吧。”
有信息,却用了错误规则。
真实意思
“你是哪里来的?
一起玩喽。”
共享规则后,沟通才成立。
学习计量经济学,也是在学习一套共同的编码—解码规则。
今天完成三次“翻译”
1
数学符号语言
说清变量、参数、误差与估计
2
回归报告语言
从软件输出读出经济含义
3
矩阵语言
把高维关系压缩成结构
课末目标:看到一种表达,能把它翻译成另外两种表达,并指出翻译中丢失了什么信息。
课前诊断:哪个最像“参数”?
先独立作答,再点击选项。
第一种语言
数学符号是计量经济学的“母语”
它把含混的社会经济叙述,编码为可检验、可推导、可复现的表达。
四句话,四个身份
\[ \begin{aligned} E(Y_i\mid X_i)&=\beta_1+\beta_2X_i && \text{总体回归函数 PRF}\\ Y_i&=\beta_1+\beta_2X_i+u_i && \text{总体回归模型 PRM}\\ \widehat{Y}_i&=\widehat{\beta}_1+\widehat{\beta}_2X_i && \text{样本回归函数 SRF}\\ Y_i&=\widehat{\beta}_1+\widehat{\beta}_2X_i+e_i && \text{样本回归模型 SRM} \end{aligned} \]
英文字母 → 变量 | 希腊字母 → 参数 | “帽子” → 估计结果
不是四个公式,而是一张地图
| 规律 / 均值 | 个体 / 观测 | |
|---|---|---|
| 总体世界 | PRF:\(E(Y_i\mid X_i)\) | PRM:再加不可观测的 \(u_i\) |
| 样本世界 | SRF:\(\widehat Y_i\) | SRM:再加可计算的 \(e_i\) |
两个关键方向:总体 → 样本是在做估计;个体 → 规律是在抽离随机波动。
快问快答:\(u_i\) 和 \(e_i\) 能互换吗?
先向同桌解释理由,再点击选项。
找茬:这段“翻译”哪里错了?
“回归得到 \(\beta_2=0.80\),说明每个人增加 1 年教育,工资必然增加 0.80 万元;
而且 \(e_i\) 是总体中所有未观测因素的真实总和。”
至少三处
- 样本回归得到的是 \(\widehat\beta_2\),不是 \(\beta_2\);
- 斜率表达的是其他条件不变时的条件均值变化,不是每个个体的必然结果;
- \(e_i\) 是样本残差,不是不可观测的总体随机干扰项 \(u_i\)。
第二种语言
回归报告是计量经济学的“暗语”
软件把大量理论、计算和诊断压缩成一张表。阅读顺序决定你会不会迷路。
先看报告,不解释
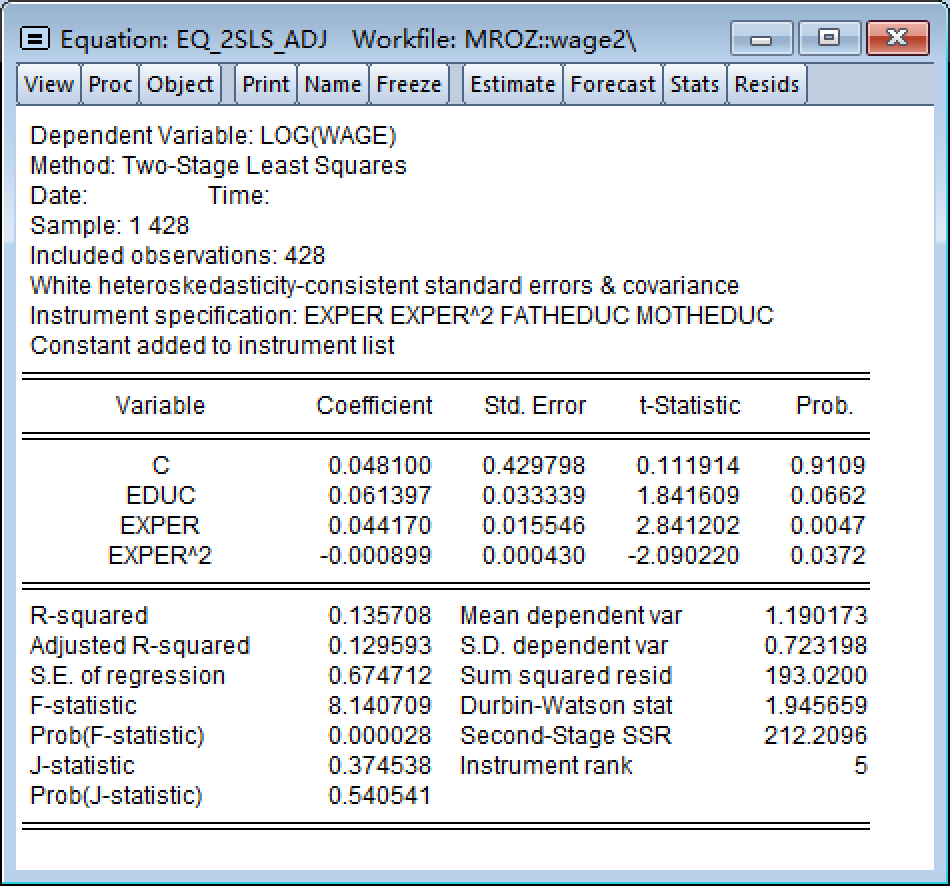
两人一组,用手指出:结果在哪里?不确定性在哪里?证据在哪里?
一张报告,只走四步
① 研究对象
因变量是谁?样本和模型是什么?
② 点估计
系数符号、大小与单位是什么?
③ 不确定性
标准误、置信区间、t 值与 p 值说什么?
④ 整体与诊断
\(R^2\)、F 检验及模型诊断是否支持结论?
不要把“p 值小”翻译成“影响很大”,也不要把“\(R^2\) 高”翻译成“模型一定正确”。
报告翻译接力
假设工资方程给出:
\[ \widehat{wage}=1.20+0.65\,educ,\qquad SE(\widehat\beta_{educ})=0.20,\quad p=0.002 \]
第 1 组
只翻译 0.65 的含义,必须说出单位与“其他条件不变”。
第 2 组
只翻译 0.20 与 0.002,区分估计精度和反对零假设的证据。
完整表达 = 经济含义 + 统计不确定性 + 适用条件。
第三种语言
矩阵是计量经济学的“狂语”
它不是为了炫技,而是为了让多个变量、多个观测和共同结构一次出现。
同一个 OLS,两个表达世界
代数语言
\[ \widehat{\beta}_2= \frac{(\sum y_ix_{2i})(\sum x_{3i}^2) -(\sum y_ix_{3i})(\sum x_{2i}x_{3i})} {(\sum x_{2i}^2)(\sum x_{3i}^2) -(\sum x_{2i}x_{3i})^2} \]
矩阵语言
\[ \widehat{\boldsymbol\beta} =(\mathbf X^\top\mathbf X)^{-1} \mathbf X^\top\mathbf y \]
矩阵不是省略逻辑,而是封装重复结构。
拆开矩阵“压缩包”
设 \(n\) 个观测、\(k\) 个待估参数:
| 符号 | 维度 | 翻译 |
|---|---|---|
| \(\mathbf y\) | \(n\times1\) | 所有观测的因变量 |
| \(\mathbf X\) | \(n\times k\) | 常数列与全部解释变量 |
| \(\boldsymbol\beta\) | \(k\times1\) | 全部总体参数 |
| \(\mathbf u\) | \(n\times1\) | 全部随机干扰项 |
\[ \mathbf y=\mathbf X\boldsymbol\beta+\mathbf u \]
维度检查:\(\mathbf X^\top\mathbf X\) 是几行几列?为什么它必须可逆?
概念检查:什么阻止了求逆?
先用“维度—秩—唯一解”的语言思考。
三种语言,指向同一个研究
模型说了什么?
对象与假设是谁?
数据给了什么结果?
证据有多不确定?
结构如何组织?
结论何时有唯一解?
真正的掌握,不是背会三套写法,而是能在三者之间往返翻译。
终极翻译任务
每组选择一个现实问题:教育与工资、价格与销量、广告与销售额……
1|符号化
写出 PRM,定义 \(Y\)、\(X\)、\(\beta\) 和 \(u\)。
2|报告化
虚构一个合理的系数、标准误和 p 值,并用一句话解释。
3|矩阵化
写成 \(\mathbf y=\mathbf X\boldsymbol\beta+\mathbf u\),标注各对象维度。
4|互译互评
邻组检查:含义是否一致?有没有把相关说成因果?
退出测验:离开教室前写下
3—2—1
- 3 个今天重新认识的符号
- 2 条阅读回归报告的规则
- 1 个仍然困惑的问题
一句话翻译
不用公式,向没有学过计量经济学的人解释:
\(\widehat{\boldsymbol\beta} =(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y\)
语言障碍靠共同规则消除;熟练翻译靠反复使用形成。
小结
数学符号让表达准确
回归报告让证据可读
矩阵语言让结构简洁
下一次看到“天书”,先问三件事:
- 它在描述总体还是样本?
- 它给出的是结果还是不确定性?
- 我能否把它翻译成另一种语言?
互动练习结束
第01章 导论|计量经济学语言